Dexcom Archive
Intention
Une archive autonome de données de mesure continue du glucose, avec des rapports de niveau clinique calculés hors ligne dans le navigateur.
Pourquoi
Les plateformes des fabricants décident combien de temps les données sont gardées et où les rapports tournent. Je voulais des années de données dans des formats ouverts, et des rapports qui tournent partout, sans serveur.
Trois dépôts forment un seul produit, reliés par un seul contrat : le schéma SQLite.
- Collecteur (Python, GitHub Actions). Une tâche quotidienne récupère chaque enregistrement via l’API Dexcom v3. Chaque passage relit les deux derniers jours, donc un passage manqué se rattrape tout seul. Les écritures sont idempotentes, le jeton OAuth, qui change à chaque passage, est stocké chiffré (AES-256-GCM), et un échec ou des données périmées ouvrent une issue d’eux-mêmes.
- Archive (SQLite). Un fichier par année, en ajout seul, avec un schéma qui ne fait que grandir. SQLite, DuckDB ou Datasette le lisent tel quel.
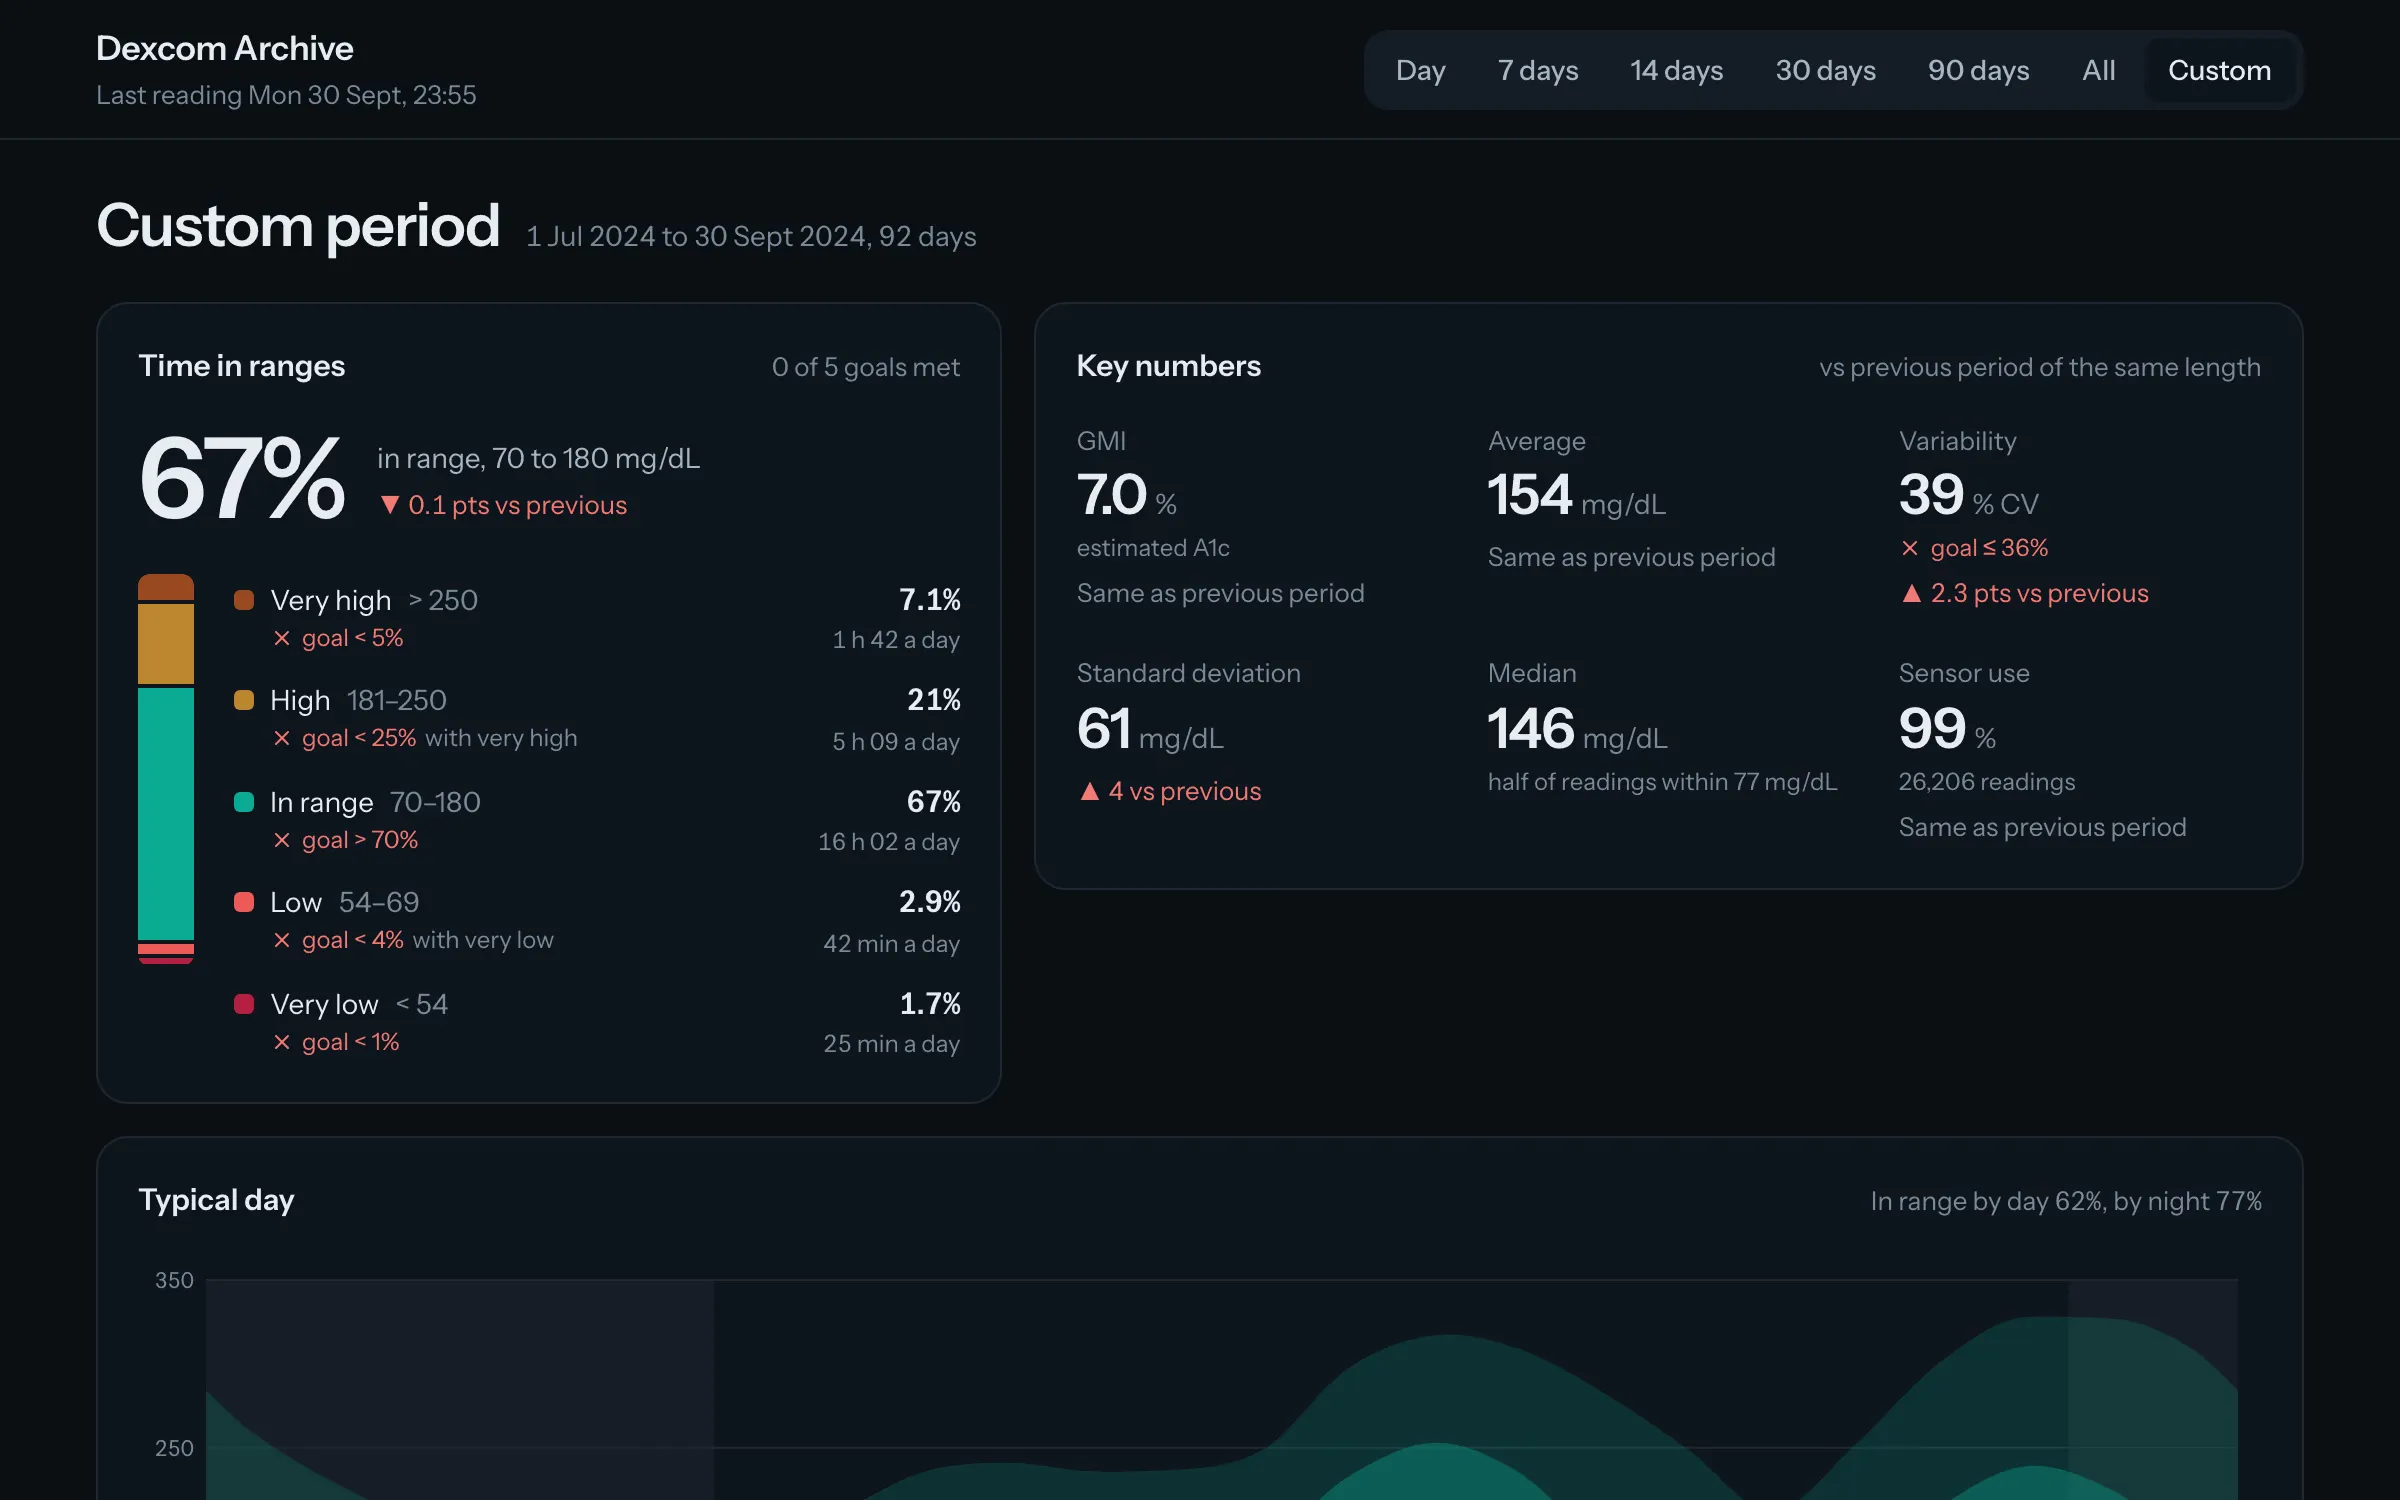
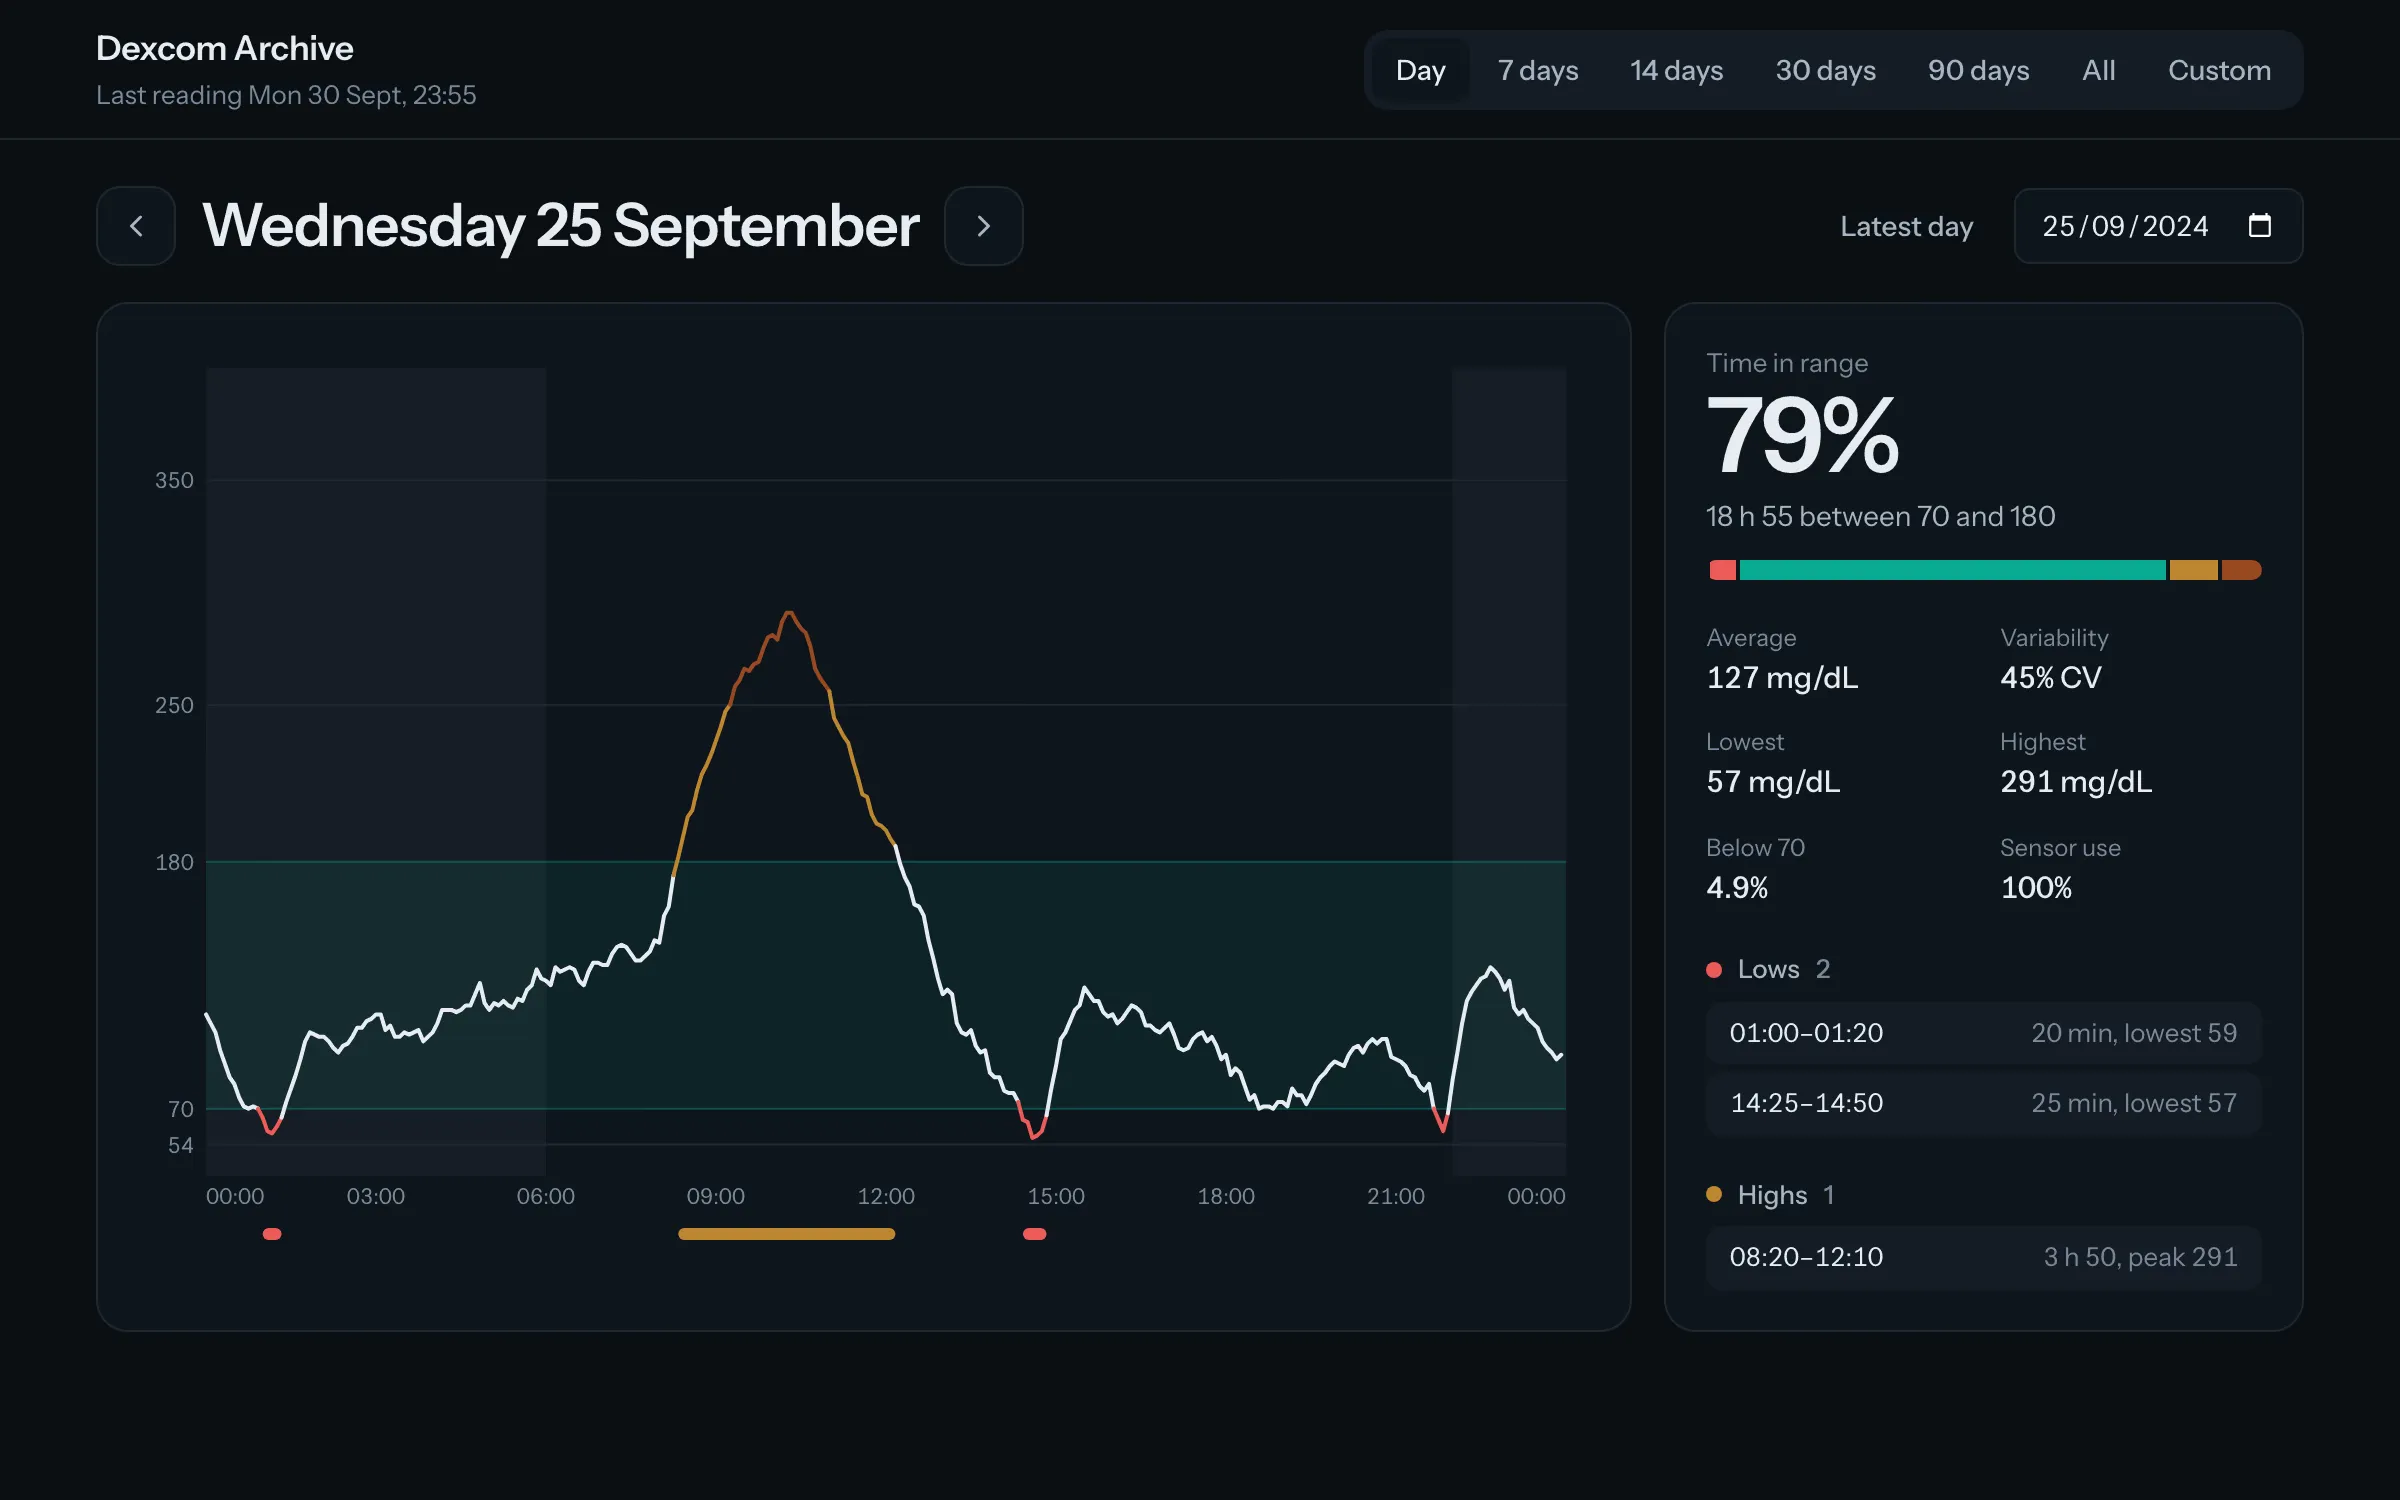
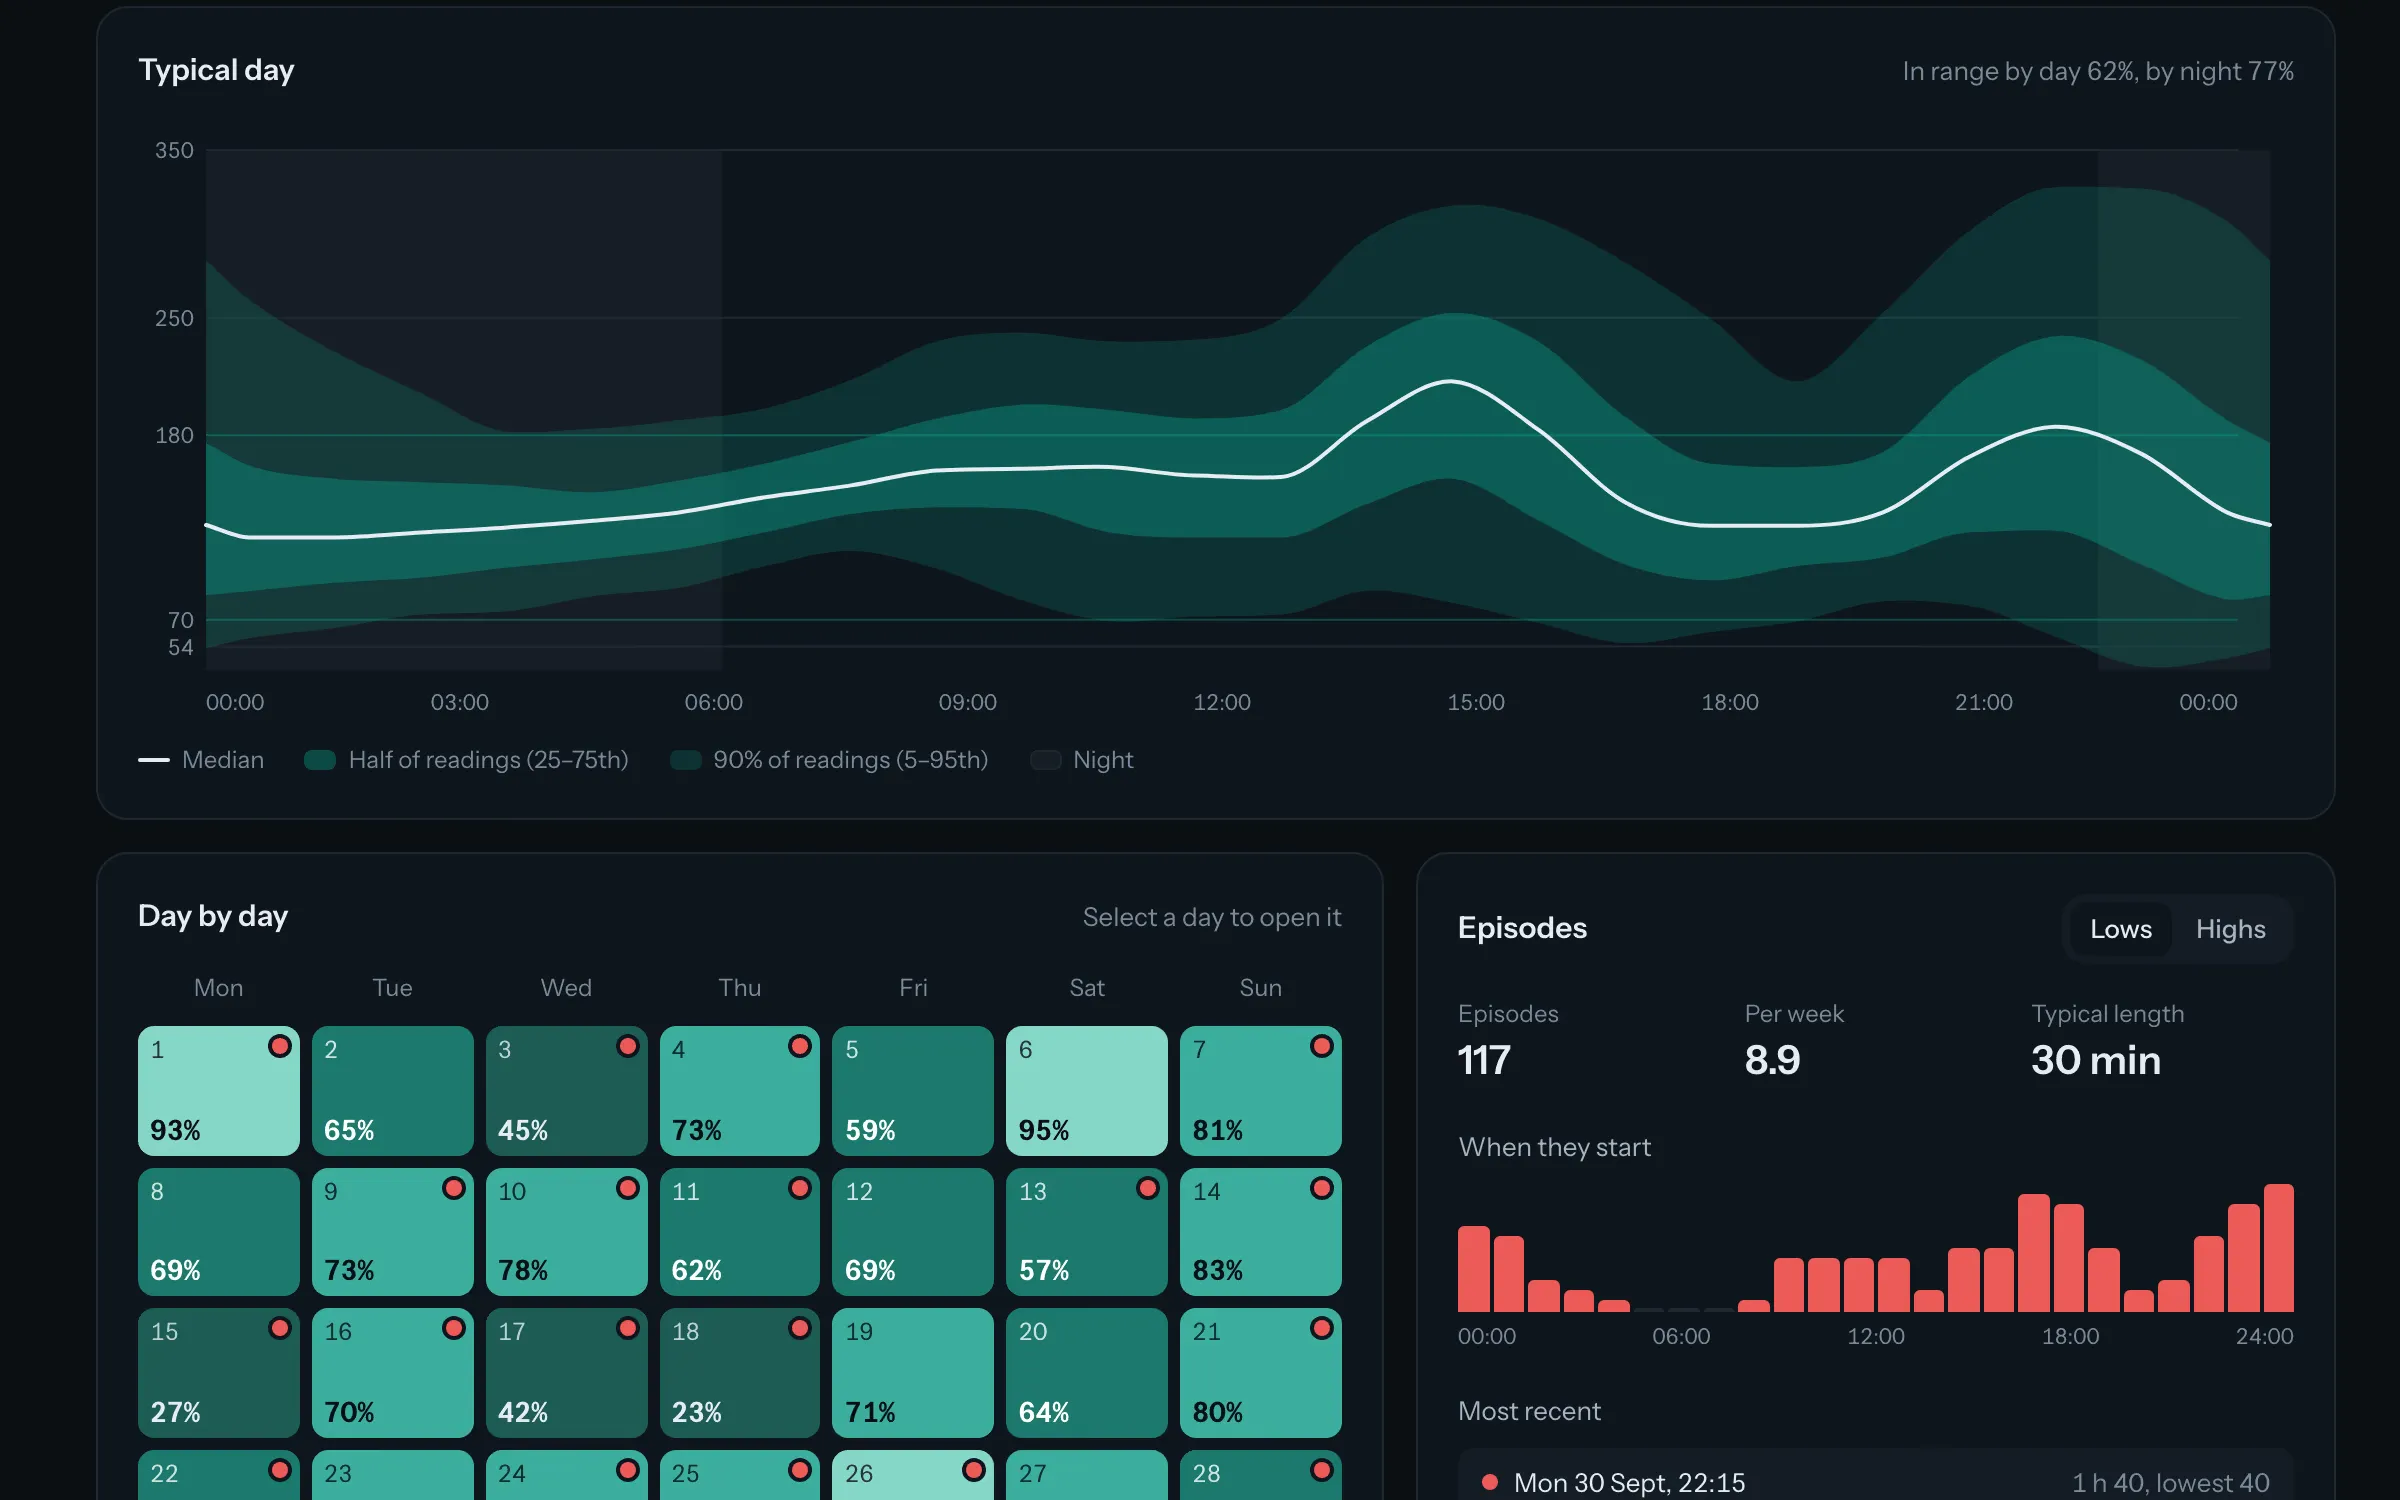
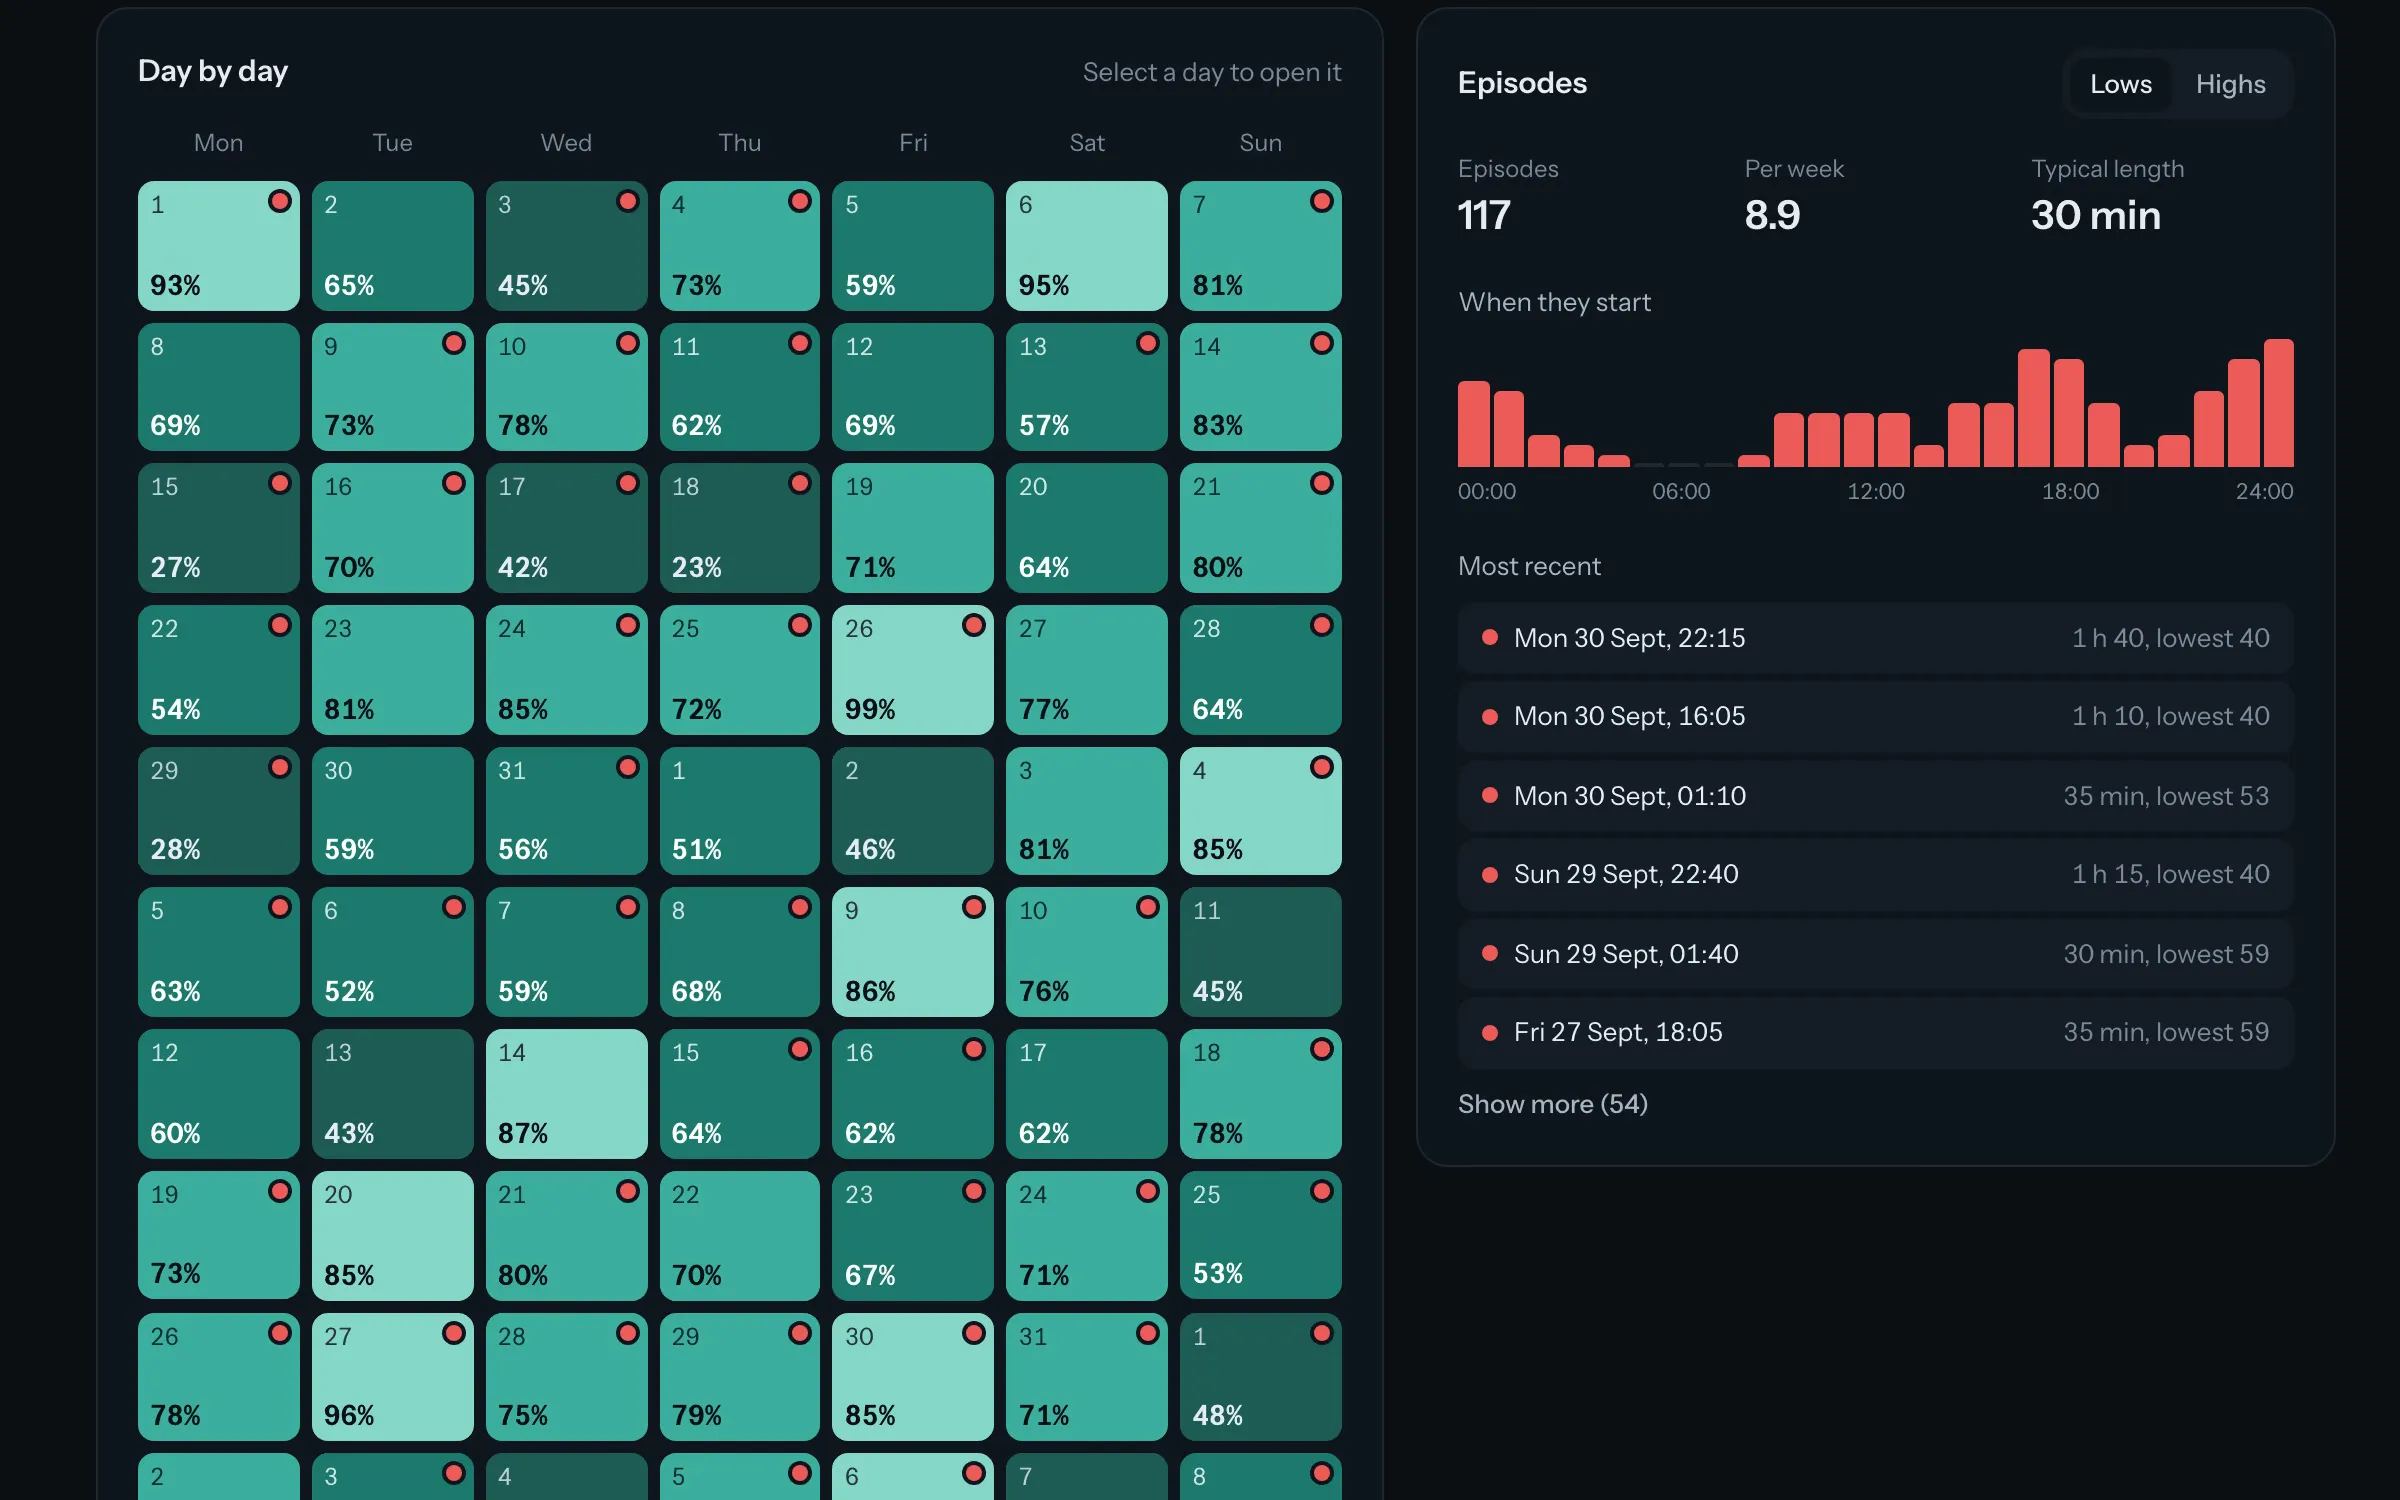
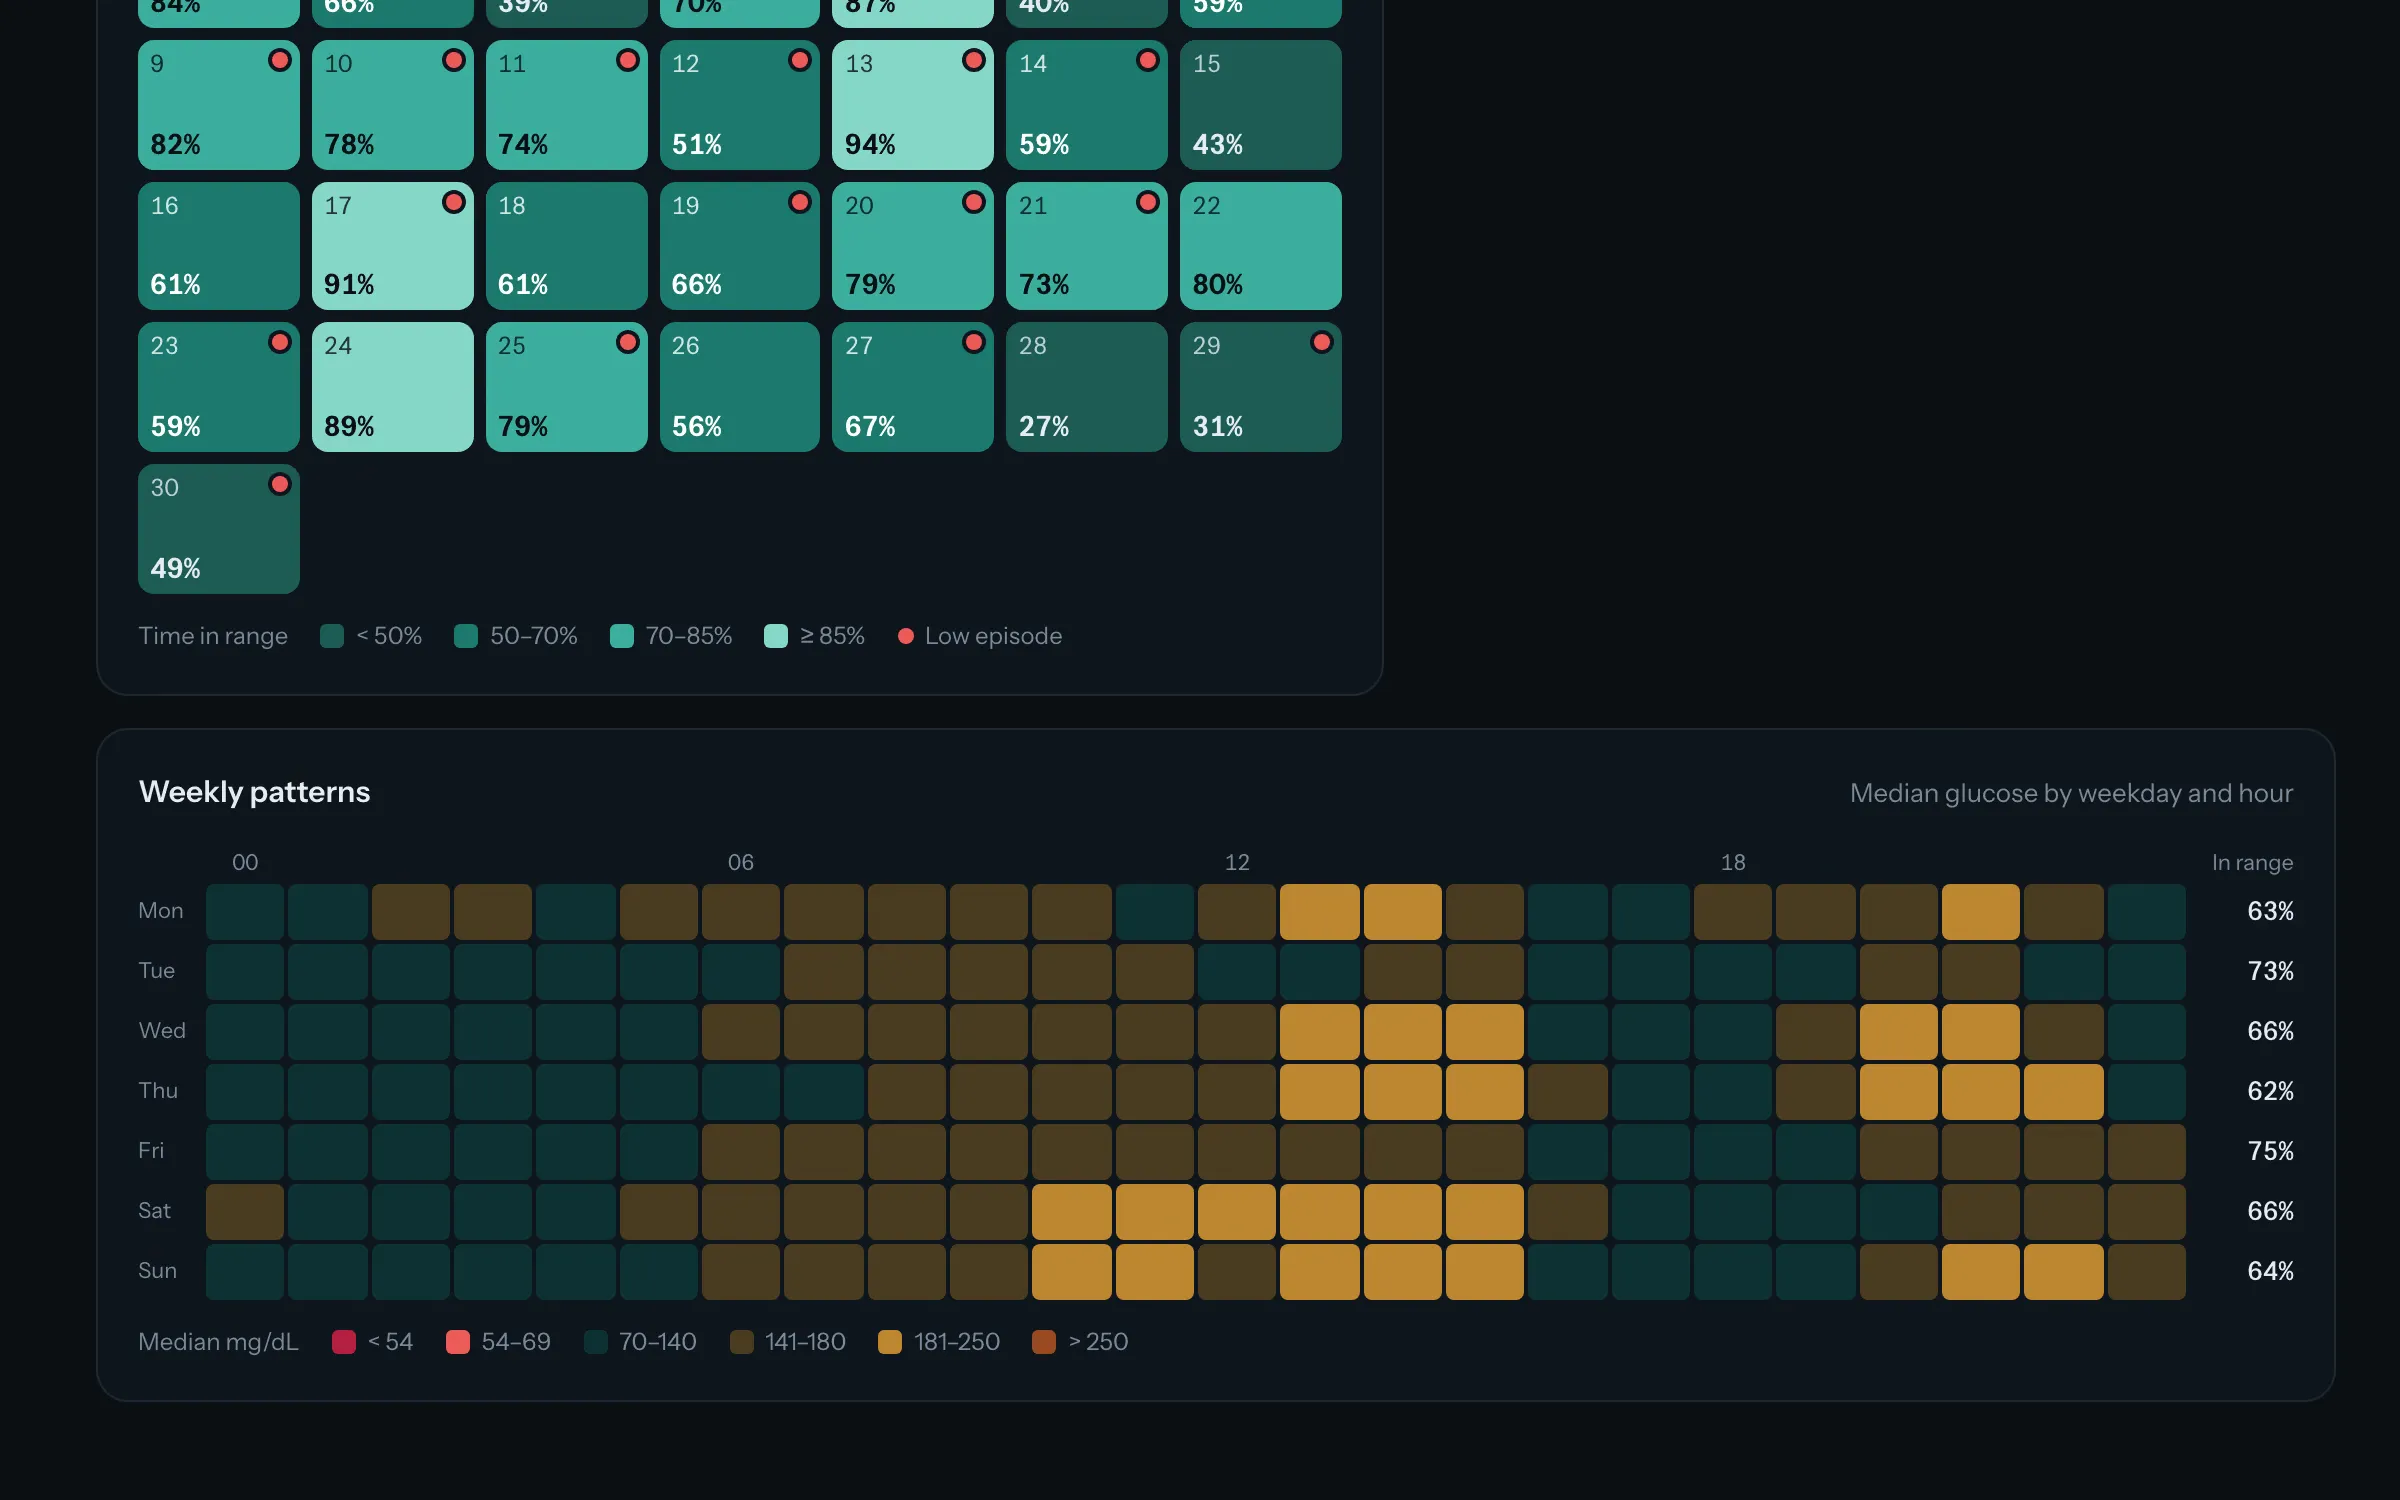
- Tableau de bord (Next.js, DuckDB-WASM). L’archive devient du Parquet et le SQL tourne dans un worker du navigateur : temps dans la cible, percentiles AGP, calendrier quotidien, épisodes, carte de chaleur jour par heure. Les graphiques sont en SVG écrit à la main, et chaque indicateur est vérifié contre une implémentation de référence en Python.
Extensible par construction : une nouvelle source de données, c’est un endpoint et une table côté collecteur. Le tableau de bord lit le schéma, jamais le collecteur, et des tests verrouillent le contrat des deux côtés.
Les données de santé restent privées : les dépôts sont privés et le tableau de bord n’écoute qu’en local. Le film et les écrans de cette page montrent six mois de données simulées de diabète de type 1, générées pour la démo.